
AI נגד כלים מסורתיים: מי מוצא יותר חולשות אבטחה?
אמ;לק
גוגל השוותה בין כלים אוטומטיים קלאסיים לבין מערכות AI בחיפוש באגים במנוע ה-JavaScript של דפדפן Chrome. התוצאות מראות שה-AI מצליח לאתר כמות משמעותית של חולשות, מה שמסמן את עתיד עולם ה-Fuzzing והאבטחה האוטומטית.
סיכום בעברית: מערכת VibeSec · מדיניות המקורות
נוסף ל-VibeSec:
כותרת מקורית: Fuzzers vs. AI: Comparing Fuzzilli and BigSleep on JavaScript Engines
התוכן המלא בעברית
תרגום אוטומטי מהמקור; מונחים טכניים נשארו באנגלית. לנוסח המחייב — הכתבה המקורית.
תַקצִיר
סיכום
Project Zero השווה שני כלים אוטומטיים שבהם Google משתמשת כדי למצוא באופן קבוע פגיעויות במנוע ה-JavaScript של Chrome, ה-V8. Fuzzilli הוא כלי Fuzzing גנרטיבי למנועי JavaScript, ו-BigSleep הוא מערכת מבוססת LLM לאיתור באגים. בששת החודשים האחרונים, BigSleep מצא יותר פגיעויות מ-Fuzzilli (45 לעומת 37), עם חפיפה של 25% בבאגים הספציפיים שדווחו. מאחר שלמתודולוגיית השוואה זו יש נטייה להמעיט בחפיפה, ביצענו גם ניסויים ייעודיים לבדיקת חפיפה תיאורטית בפגיעויות שדווחו מאז 2023. ניסויים אלו העריכו את החפיפה בערך ב-60%. ללא קשר לערך המדויק, חלק ניכר מהפגיעויות היו ניתנות לגילוי על ידי LLMs בלבד או על ידי Fuzzing בלבד. בעוד שזה מבטיח ביותר ש-LLMs מסוגלים למצוא כל כך הרבה פגיעויות במהירות כזו, Fuzzing ו-LLMs נותרו גישות משלימות. אנו ממליצים לספקים לבצע גם Fuzzing וגם ניתוח סוכנים (agentic analysis) לקוד שלהם, כדי למקסם את מספר הפגיעויות שמדווחות לפני שהן משפיעות על המשתמשים.
מָבוֹא
מבוא
טכניקת ה-Fuzzing מיושמת מזה זמן רב בהצלחה בפרויקטי תוכנה כגון Chrome או V8 (מנוע ה-JavaScript של Chrome) כדי לזהות באגים. לאחרונה, הגעתם של LLMs עוצמתיים המסוגלים לקרוא, לנמק ולכתוב קוד מחוללת שינוי מהפכני בפיתוח תוכנה ובאבטחת תוכנה. עם מאות ואף אלפי באגים ופגיעויות חדשים שמתגלים במטרות שעברו Fuzzing אינטנסיבי, עולה שאלה טבעית: כיצד LLMs חדשים משתווים ל-fuzzers "מסורתיים"? האם הם מתחילים להחליף אותם, או ששתי הגישות משלימות זו את זו? כדי לענות על כך, אנו בוחנים שלוש שאלות מרכזיות:
• כמה באגים מוצאת כל גישה בעולם האמיתי?
• מהי החפיפה בין שתי הגישות?
• מהי "צורתם" של באגים שהתגלו על ידי מערכת אחת אך לא על ידי מערכת אחרת?
עבור פוסט זה, נגביל את עצמנו לשתי מערכות קונקרטיות: Fuzzilli, כלי Fuzzing למנוע JavaScript, ו-BigSleep, מערכת סוכנת (agentic) לאיתור באגים. שתי המערכות פועלות בסביבת הייצור ומחפשות אוטומטית באגים בקוד שנוסף לאחרונה, מה שהופך אותן לניתנות להשוואה ישירה למדי. באופן ספציפי, Fuzzilli פועל באופן רציף על פני מופעים רבים, כאשר הראשונים בדרך כלל קולטים שינויים חדשים תוך מספר שעות, בעוד BigSleep פועל כיום פעם ביום ומתבקש לסקור Commits חדשים ולכתוב מקרי בדיקה מסוג Proof-of-Concept עבור כל באג שהוא מגלה. שתי המערכות מדווחות על באגים דרך Clusterfuzz, אשר מבצע טריאז' (תעדוף/מיון) בסיסי לקריסות, ולאחר מכן פותח דוחות באגים ב-issue tracker של Chrome.
אנו מגבילים את עצמנו ל-V8 כיעד – מנוע JavaScript ו-WebAssembly בעל ביצועים גבוהים עם מערך בדיקות ו-Fuzzing מתוחכם ובוגר. בפרט, Fuzzilli הוא כלי Fuzzing ייעודי שנועד למצוא באגים במנועים אלה. האופי המורכב בדרך כלל של באגים אלו יוצר "מגרש משחקים" מעניין להשוואת היכולת של שתי הגישות למצוא באגים עמוקים ומורכבים בתוכנות שנבדקו היטב. אנו משאירים לעבודה עתידית את ביצוע הניתוח הדומה על מערך רחב יותר של מטרות, Fuzzers ומערכות סוכנות לאיתור באגים.
כעת נבחן כל אחת משלוש השאלות העיקריות בחלק ייעודי. כל חלק יסכם תחילה את הגישה הכללית, ולאחר מכן יתאר את המתודולוגיה בפירוט (לעתים קרובות כנקודות, כך שתוכל לדלג עליהן אם אינך מעוניין בפרטים), לפני שנצלול לתוצאות. אנו מסיימים בניסיון לפרש את התוצאות כדי לקבל תמונה של המצב הנוכחי של Fuzzing לעומת AI.
זהו החלק הפשוט ביותר לניתוח, אם כי עם כמה סייגים שנראה בהמשך. הרעיון הבסיסי הוא לבצע שאילתות על בעיות מ-bugtracker של Chromium (שם עוקבים אחר באגי V8) ולחלץ משם נתונים סטטיסטיים שונים. זה קל במיוחד מכיוון שיש Hotlist ייעודי לכל אחת משתי המערכות. אנו מגבילים את הניתוח שלנו לששת החודשים שבין אפריל לספטמבר 2026, שכן הצינור האוטומטי של BigSleep הפך לפעיל רק באפריל השנה. הנתונים הגולמיים שלנו מגיעים משתי השאילתות הבאות למעקב אחר באגים:
• Fuzzilli: hotlistid:5433121 נוצר:2026-04-01..2026-09-30
• BigSleep: hotlistid:8067258 נוצר:2026-04-01..2026-09-30
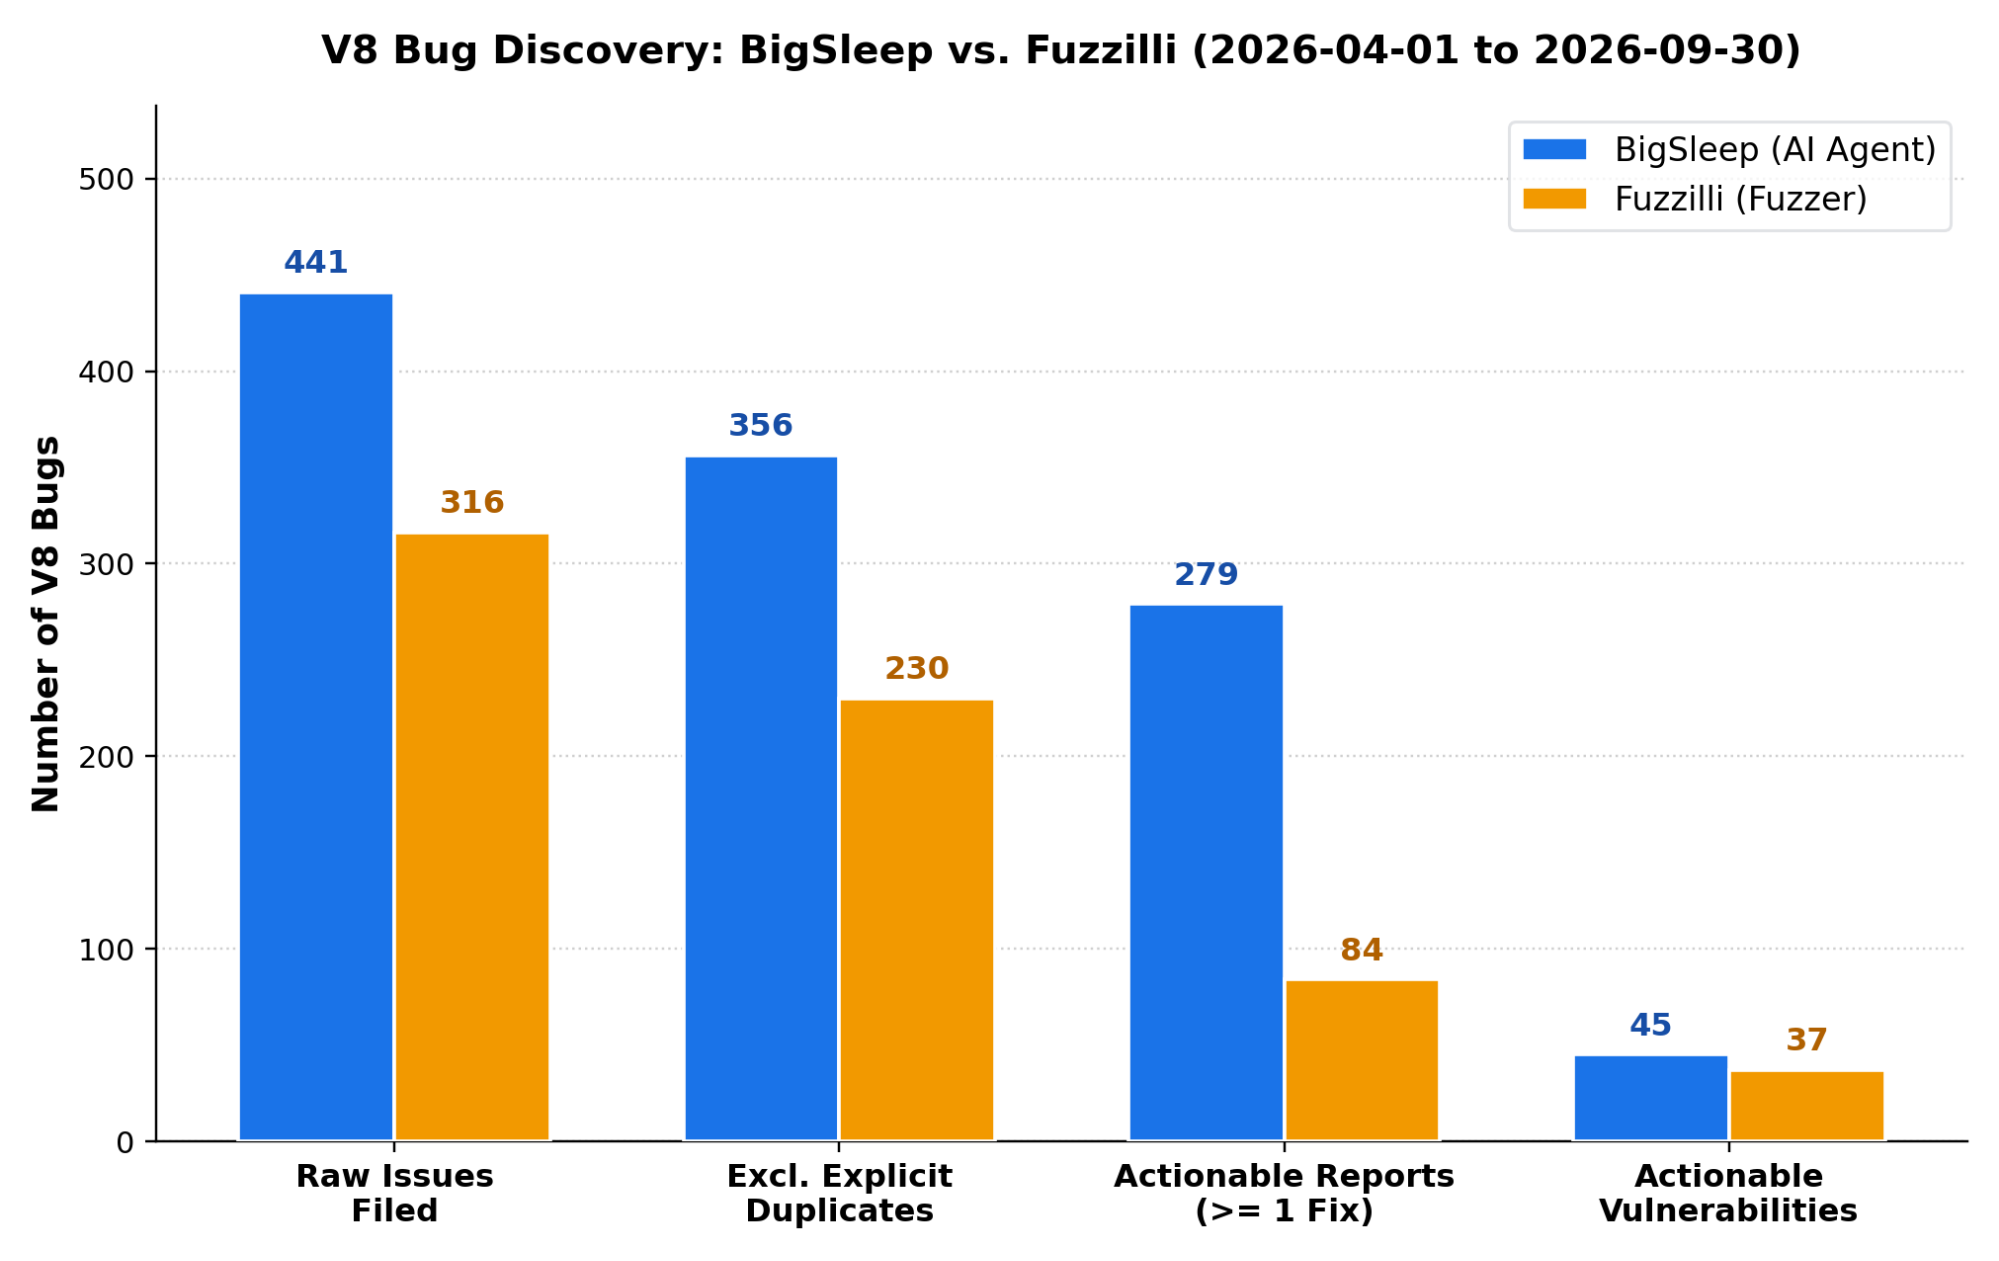
משם, המספרים הגולמיים של דוחות באגים הם:
ניצחון קטן עבור BigSleep. עם זאת, נתון זה כולל את כל סוגי הבאגים, ו-BigSleep מצא בתחילה גם בעיות תצורה ואינטגרציה רבות ב-V8, למשל crbug.com/503869331, שבה מנגנון חסימת ה-unsafe flag עדיין לא פעל כראוי. אלו הן בעיות לגיטימיות, אך פחות רלוונטיות להשוואה שלנו מכיוון שיש להן השפעה זניחה על האבטחה בעולם האמיתי. דרך קלה אחת להוציא אותן היא להסתכל ספציפית על פגיעויות על ידי הגבלת התוצאות ל-type:vulnerability:
פתאום ניצחון ברור ל-Fuzzers? לא בדיוק. עדיין קיימות בעיות מסוימות עם הנתונים הללו, בעיקר כפילויות ודוחות שלא ניתן לפעול לפיהם (למשל, באגים שנסגרו כ-WAI - Works As Intended). בהתחלה זה נראה דבר פשוט לתיקון: פשוט להוסיף אילוץ נוסף כגון status:(fixed | verified). למרבה הצער, הדברים מעט מורכבים יותר. קחו למשל את באג Fuzzilli מס' crbug.com/511935486. האירועים בבאג זה הם בעצם:
• הבאג מוגש על ידי Clusterfuzz ב-11 במאי ומוקצה למהנדס
• הבאג נסגר על ידי Clusterfuzz מכיוון שמקרה הבדיקה כבר לא משתכפל מאוחר יותר באותו יום
כתוצאה מכך, הבאג הזה לא קיבל אינטראקציות מצד מפתחים. סביר להניח שמה שקרה הוא שהבאג הזה היה כפיל של באג אחר, crbug.com/511210507, אך Clusterfuzz לא זיהה זאת מכיוון שחתימת ההתרסקות (הנגזרת מ-stack trace) הייתה שונה במקצת. כאשר הבאג האחר תוקן, מקרה הבדיקה הפסיק לשחזר את הקריסה ב-Clusterfuzz, מה שגרם לסגירת הנושא.
אולי הדבר הטוב ביותר שאנו יכולים לעשות הוא להסתכל על באגים "ניתנים לפעולה" (actionable), המוגדרים ככאלה שאינם מסומנים ככפולים או כ-WAI ושקיבלו לפחות Commit אחד של תיקון המפנה אליהם. לאחר מכן, התמקדות בבאגים מסוג Type-Vuln בלבד מסננת הרבה מהבאגים הפחות רלוונטיים של BigSleep, למרות שהם היו "ניתנים לפעולה". עם זאת, התמונה הסופית נראית כך:
אז מבחינת נקודות תורפה, זה בערך שוויון (יתרון קטן BigSleep) כרגע: 45 לעומת 37.
זה מעלה באופן טבעי את שאלת העלות: כמה יקרה כל אחת משתי הגישות ומה זה אומר במונחים של עלות לכל באג? למרבה הצער, מאתגר לערוך השוואה בשלב זה של המחקר. אמנם הוקדש מאמץ מסוים כדי להפוך את Clusterfuzz ליעילה יותר, אך מאמץ דומה לא הושקע עבור BigSleep, ואף אחת מהמערכות אינה מכוילת במיוחד ליחס עלות-לבאג אופטימלי.
השאלה הבאה היא עד כמה הגישות הללו חופפות. לשם כך, הגישה שלנו כפולה: ראשית, אנו מנסים למצוא תשובה ב-bugtracker על ידי ניסיון לזהות באגים שהתגלו על ידי שתי המערכות. לאחר מכן, אנו מריצים ניסוי ייעודי שבו אנו מאפשרים ל-BigSleep לנסות לגלות מחדש באגים ישנים של Fuzzilli.
Bugtracker Overlap
הרעיון הבסיסי הוא לראות אילו באגים נמצאו על ידי שתי המערכות, ולכן אנו מחפשים למעשה דוחות באגים כפולים. בדומה לחלק 1, יש כמה צעדים שעלינו לנקוט כדי להבטיח שנקבל תמונה מעט מדויקת:
• ראשית, אנו מחפשים באגים שהוגשו על ידי מערכת אחת, אשר הופכים את הכפילות לבאג שהוגש על ידי המערכת השנייה. למשל crbug.com/522410841 שהוא עותק של crbug.com/522860268 . זוהי חפיפה ברורה.
• לאחר מכן, עלינו לקחת בחשבון שדוחות רבים "לא ניתנים לפעולה" (אלו עם אפס תיקונים משויכים) הם לעתים קרובות כפילויות. עבור דיווחים אלה, עלינו למצוא את ה-commit שתיקן אותם, ואז להסתכל על הבאג המשויך ל-commit הזה, ולהתייחס לשני הבאגים האלה ככפולים. זה יכול להיות קשר רב-שוני: גם באג X שנמצא על ידי BigSleep וגם באג Y שנמצא על ידי Fuzzilli עשויים להיות כפיל של באג Z שדווח על ידי someone/something אחר. במקרה כזה, הבאג הזה עדיין נחשב כחפיפה.
• לאחר מכן, עלינו להבין שכפילויות רבות מעולם לא מקבלות ערך ב-bugtracker מכיוון שהן כבר עוברות דה-דופליקציה (ביטול כפילויות) ברמת Clusterfuzz (שכן גם Fuzzilli וגם BigSleep מסתמכים על Clusterfuzz עבור טריאז' בסיסי ותיוק באגים). ככאלה, עלינו לבצע שאילתות במסד הנתונים הבסיסי של Clusterfuzz כדי למצוא כפילויות נוספות.
• לבסוף, עלינו להחליט מה לעשות עם באגים נפרדים שמתוקנים על ידי אותו CL, למשל ארבעת הבאגים שתוקנו על ידי crrev.com/c/7965120 . למרות שזה יכול לקרות באופן לגיטימי עבור באגים שונים, סביר להניח שהבאגים יהיו כפולים (כגון במקרה זה), ולכן אנו סופרים אותם ככאלה.
עם כל הסוגים השונים של מניעת כפילות, אנו מקבלים את התמונה הסופית הזו:
שוב, בהסתכלות רק על דוחות הפגיעות הניתנים לפעולה (כנראה המדד הטוב ביותר), אנו רואים חפיפה של כ-25% (20 מתוך סך של 81), כאשר רוב קל של אלה נמצאו תחילה על ידי Fuzzilli ואחר כך על ידי BigSleep.
Overlap Experiment
הדרך השנייה למדוד את החפיפה היא להפעיל ניסוי ייעודי שבו אנו מנסים לגלות מחדש באגים שנמצאו בעבר על ידי מערכת אחת, תוך שימוש במערכת השנייה. באופן ספציפי, כאן אנו מנסים לגלות מחדש באגי Fuzzilli ישנים באמצעות הגדרת BigSleep הקרובה ככל האפשר לתצורת הייצור. עבור כל באג, אנו אוספים את ה-Commit ש(ככל הנראה) הציג את הבאג, ומבקשים מהסוכן לסקור את השינויים הללו בדיוק כפי שקורה בסביבת הייצור (CI). שים לב שהכיוון ההפוך – ניסיון לגלות מחדש באגי BigSleep מהעבר באמצעות Fuzzilli – קשה יותר להגדרה, מכיוון שלא ניתן לתת ל-fuzzers בקלות "נקודת התחלה" דומה. יתרה מכך, עבור רבים מהבאגים הללו אנחנו כבר יודעים את התוצאה: רוב באגי ה-BigSleep ה"היסטוריים" (למשל אלו משנת 2025) נמצאו לאחר ש-fuzzers כמו Fuzzilli כבר סרקו מבנים פגיעים במשך חודשים, ולעיתים שנים. לכן, סביר להניח שהם לא יגלו אותם מחדש בניסוי (למעט אולי במקרים בודדים שבהם Fuzzilli עודכן מאז כדי לתמוך בתכונות שפה חדשות). באופן דומה, בייצור, BigSleep מדווח על קריסות באיחור של 1-2 ימים (שכן יש כיום רק ריצה אחת ביום). כתוצאה מכך, ה-fuzzers מקבלים יתרון של זמן.
בפירוט רב יותר, הנה אופן הגדרת הניסוי:
• אנו מתחילים עם רשימה של באגים היסטוריים Fuzzilli (מתחילת 2023 עד אמצע 2026) על ידי שאילתה ברשימת החמים של מעקב הבאגים. זה נותן לנו בערך 1150 באגים גולמיים.
• אנו מגבילים זאת ל-type:vulnerability בלבד מכיוון שאלו סוגי הבאגים שהכי אכפת לנו מהם ויסירו קצת "רעש" כמו לעיל. נשארנו עם בערך 600 נקודות תורפה.
• לאחר מכן, אנו מסננים את הרשימה הזו לבאגים שמתרבים בסביבה שבה משתמש הסוכן. זה כולל שני חלקים: באגים שמשתכפלים על x64 בניית באגים+אסן של המעטפת d8 כפי שמסופקת על ידי תשתית הבנייה הציבורית של Chrome. זה חשוב מכיוון שבאגים רבים מתרבים רק בבנייה מיוחדת, למשל מכיוון שהם ספציפיים לארכיטקטורה או זקוקים לתכונות מסוימות בזמן הידור.
• באגים שניתן לשחזר ללא דגלים מיוחדים. הבעיה כאן היא ש-fuzzers מגדירים לעתים קרובות דגלים מותאמים אישית, בין אם כדי להפעיל תכונות בפיתוח (למשל --experimental-wasm-jspi ב-crbug.com/361123483) או כדי להפעיל מצבי Fuzzing שונים שמקלים על גילוי סוגים מסוימים של באגים (למשל --deopt-every-n-times ב-crbug.com/362784006). עם זאת, איננו יכולים לתת לסוכן להגדיר דגלים שרירותיים על בניית V8 היסטורית, מכיוון שלא היה להן מצב של "דגלים בטוחים בלבד" (מה שמוביל לקריסות חיוביות-שגויות רבות), ואיננו רוצים לומר לסוכן באילו דגלים עליו להשתמש עבור אתגר נתון, שכן זה יהווה רמז. ככזה, למען הפשטות, אנו מגבילים את עצמנו לבאגים שניתן לשחזר עם סט סטנדרטי של דגלים (--fuzzing, --jit-fuzzing, --expose-gc) ומאפשרים לסוכן להגדיר רק אותם.
• כעת אנו מבצעים ביטול כפילויות בדומה למה שעשינו למעלה כדי לזהות כפילויות מרומזות, שאנו מסירים. זה משאיר אותנו עם מספר סופי של 112 באגים.
קריאה וכלים קשורים
אבטחת Node.js / JS / TS- Bearer — SAST עם התמקדות בפרטיות ו-PII
- CodeQL — מנוע ניתוח סטטי של GitHub
- Dependabot — עדכונים אוטומטיים לתלויות פגיעות
- עדכון כלי בקרת הקוד markdownlint-cli
- הקוד נוצר ב-10 שניות, הבדיקה לקחה 3 ימים: למה צריך ארכיטקטורה בקוד של AI
- הכירו את HTTP2Shell: סיכון אבטחה בטכנולוגיית הדחיסה Brotli