
בדיקת תנאי מירוץ עם מעקב גישה לזיכרון והזרקת השהיה מבוססת מחסנית
אמ;לק
תנאי מירוץ (Race Conditions) הם פגיעויות אבטחה נפוצות בקוד מקבילי, הנוצרות כתוצאה מסדר ביצוע בלתי צפוי של תהליכונים. כלי זה מסייע בזיהוי ורגרסיה של באגים מסוג זה על ידי מעקב גישה לזיכרון והזרקת השהיות יזומות. השיטה מציעה פתרון לאתגרים בבדיקה אוטומטית של תנאי מירוץ.
סיכום בעברית: מערכת VibeSec · מדיניות המקורות
נוסף ל-VibeSec:
כותרת מקורית: Testing race conditions with memory access tracing and stack-based delay injection
התוכן המלא בעברית
תרגום אוטומטי מהמקור; מונחים טכניים נשארו באנגלית. לנוסח המחייב — הכתבה המקורית.
באגי אבטחה רבים הם תנאי מירוץ (race conditions), שבהם ביצוע ריבוי-הליכי (multi-threaded) חייב להתרחש בשזירה (interleaving) ספציפית כדי להוביל להשפעה שלילית. מצב זה יוצר אתגרים עבור מספר תרחישי שימוש:
• אישור מועמדי באגים שהתגלו באופן ידני או באמצעות ניתוח סטטי.
• מבחני רגרסיה: לאחר תיקון באג של תנאי מירוץ, לרוב אין דרך טובה לכתוב מבחן רגרסיה שמפעיל את הבאג באופן מהימן כחלק מחבילת בדיקות.
• גילוי אוטומטי של באגים, כגון Fuzzing: ל-fuzzer קשה לממש את כל השזירות המעניינות של פעולות במקביל, או להגיע לנתיבי קוד שמתופעלים רק כאשר הפעולות רצות במירוץ.
אני מגלה באגים בעיקר על ידי קריאה ידנית של קוד. כשאני חושב שמצאתי באג, אני בדרך כלל כותב מקרה מבחן כדי להוכיח או להפריך את קיומו. עבור באגים של תנאי מירוץ, קשה להשיג אחת מהתוצאות הללו. עבור באגים בליבת Linux, אני לרוב פונה להידור מחדש של הליבה לאחר הוספת קריאות mdelay() מותנות (המבצעות spinloop למשך זמן מוגדר בערך) במקומות המתאימים; אני בדרך כלל מתנה אותן בשם ה-thread הפועל, אם כי לעיתים נדרשים תנאים מורכבים יותר. בפלטפורמות התומכות ב-DTrace (כמו macOS ו-Windows), ניתן להשתמש ב-DTrace probes שקוראים ל-chill() לקבלת השפעה דומה, אם כי התועלת מוגבלת מכיוון ש-DTrace יכול לעקוב רק אחר גבולות פונקציות שאינן מוטבעות (non-inline) או נקודות מעקב מפורשות, ולא אחר כל הוראת מעבד (instruction). ללא קשר לפלטפורמה, גישה זו עלולה לגזול זמן רב ולדרוש ניסוי וטעייה כדי לקבוע בוודאות אם הקוד מכיל באג.
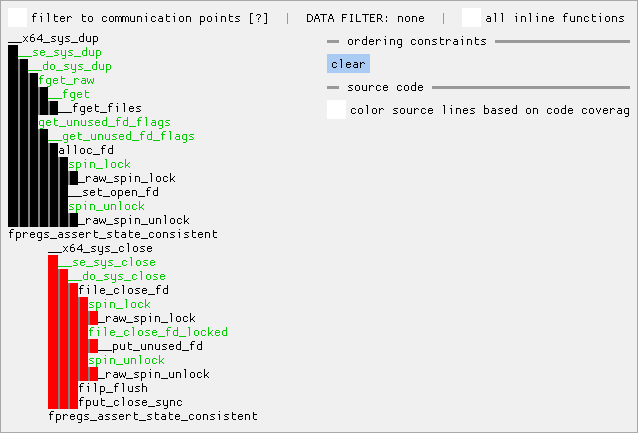
בנוסף, בליבת Linux, תיקונים עבור באגים של תנאי מירוץ מלווים לעיתים קרובות בדיאגרמות ASCII בכתב יד המציגות שזירת תהליכונים (threads) בעייתית עם תרשימי קריאה (call graphs) וגישות רלוונטיות לזיכרון (לדוגמה, ראה תיקון rt_spin_unlock UAF אחרון זה, או תיקון jbd2 deadlock זה). היה נוח יותר לקבל כלי פיתוח המסוגלים לנתח קוד פגיע פוטנציאלי ולהציג תוצאות בייצוג דומה.
תַקצִיר
כתבתי כלים לבחינת שזירות אפשריות של מקרי בדיקה מרובי-הליכיים עבור ליבת Linux:
• כלי שבודק אוטומטית את כל השזירות האפשריות A-B-A של מקרה בדיקה.
• טרמינל UI לחקירה ידנית של שזירות אפשריות.
• GUI לחקירה ידנית של שזירות אפשריות.
חלק הליבה מיועד גם לגילוי תנאי מירוץ באמצעות Fuzzing, אך טרם יושמו כלי מרחב-משתמש (userspace) לכך.
הכלים זמינים ב-GitHub תחת השם MAccConc, קיצור של "Memory Access Concurrency"; עיין ב-README שם להוראות התקנה ושימוש.
אם אתה רק רוצה לראות את הכלים בפעולה, דלג אל Demo: בדיקה אוטומטית.
אם אתם מתעניינים רק בתיאוריה שמאחורי הכלים, קראו את הסעיף Stable identifiers for memory accesses across runs: count-augmented stack traces.
עבודה קודמת
פרויקט זה נוצר בהשראת דיונים עם Ned Williamson, שפרויקט ה-sockfuzzer שלו כלל חקירה של באגי מקביליות באמצעות מתזמן מותאם אישית שיכול לתזמן מחדש בפרימיטיבי סנכרון כדי לחקור שזירות. ראה את שקופיות ההרצאות והקלטת הוועידה המתמקדות בהיבט בדיקת המקביליות של הפרויקט.
הכלים שלי מבוססים במידה רבה על רעיונות הדומים ל-SKI , אך SKI משתמש ביישום אחר: הוא מתעד גישה לזיכרון ושולט בתזמון של vCPUs באמצעות גרסה מתוקנת של QEMU במצב TCG ומשתמש ב-VM בצילומי מצב כדי לחקור שזירות ביצוע שונות.
גילוי גישות לזיכרון שעלולות לתרום לתנאי מירוץ (נקודות תקשורת)
כפי שמתואר במאמר SKI, ניתן לגלות שזירות ביצוע מעניינות של מקרה בדיקה מרובה-הליכיים על ידי מעקב אחר גישות זיכרון של כל ה-threads וחיפוש זוגות גישות בשני threads שיכולים לקיים אינטראקציה זה עם זה – כלומר, שלפחות אחת מהן היא פעולת כתיבה, והן ניגשות לטווחי זיכרון חופפים. המאמר של SKI מכנה גישות זיכרון כאלה "נקודות תקשורת" (communication points).
זה דורש מנגנון כלשהו לאיסוף כיסוי גישה לזיכרון. SKI ביצע זאת על ידי תיקון מצב ה-TCG של QEMU; אני מסתמך במקום זאת על מכשור ASAN במצב "outline" (דגל המהדר asan-instrumentation-with-call-threshold=0, הנבחר על ידי CONFIG_KASAN_OUTLINE בליבת Linux), אשר יוצר קריאות לפונקציות עזר בגישה לזיכרון. אני מאמין שהליבה היא המקום הנכון לאסוף נתונים אלה מכיוון שהיא תאפשר לספק מידע ברמה גבוהה יותר על אירועי נעילה (lock acquire/release), אם כי טרם יישמתי זאת. יישום זה בליבה אומר שתיאורטית ניתן יהיה לבדוק על חומרה חשופה (bare-metal), ולא רק בתוך VMs.
מכיוון שב-Linux כבר קיים KCOV כמנגנון להזנת מידע על כיסוי בלוקים בסיסיים של הליבה למרחב המשתמש, החלטתי להשתמש באותו מנגנון לתיעוד גישות זיכרון. חלופה אחרת הייתה שימוש ב-ftrace, המכוון למעקב אחר תרחישי שימוש וכולל מצב מעקב גרף פונקציות הבנוי על fentry hooks וניהול חוצץ פלט מורכב יותר המותאם לאיסוף נתונים כלל-מערכתי. בחרתי ב-KCOV בגלל הייצוג הפשוט יותר שלו בזיכרון של נתוני העקבות (דבר שעשוי להיות רלוונטי לשחזור נתונים מ-VMs שקרסו); מכיוון שהוא משתמש במכשור סטטי שפועל תמיד ולא במכשור התומך בזמן ריצה עם תקורה כמעט אפס במצב מושבת; ומכיוון שהתרשמותי היא ש-KCOV מיועד לאירועי מעקב בתדירות גבוהה יותר מאשר ftrace.
פרטי מימוש: ASAN ו-TSAN
ASAN בדרך כלל ממזג קריאות מסייעות לגישות זיכרון עוקבות. כדי לקבל התקשרות חוזרת אחת לכל גישה לזיכרון, תיקוני הליבה משביתים במפורש את האופטימיזציה של המהדר באמצעות דגל ה-asan-opt-same-temp backend.
ASAN מיועד לזיהוי UAF, לכן הוא לא פולט קריאות עזר בגישה ישירה לזיכרון מחסנית (stack) אלא אם כן יש פוטנציאל לגישה מחוץ לתחום (out-of-bounds). משמעות הדבר היא שמצבי מירוץ מסוימים הכוללים אובייקטים על המחסנית, כגון תורי המתנה, עשויים שלא להיות מזוהים באמצעותו. ASAN גם לא פולט כברירת מחדל קריאות עזר לגישה למשתנים גלובליים, אך ניתן לבטל אופטימיזציה זו באמצעות דגל ה-backend asan-opt-globals.
חלופה תהיה שימוש במכשור TSAN, המיועד לזיהוי גזעי נתונים (data races) ומספק גם מידע על אטומיות גישה. החיסרון של TSAN הוא שמהדרים אינם תומכים בפליטת ה-hooks של ASAN ו-TSAN בו-זמנית – לכן, כדי להמשיך בזיהוי הפרות בטיחות זיכרון (כמו UAF) תוך שימוש ב-hooks של TSAN, יהיה צורך להפעיל את יישום ה-ASAN של הליבה דרך ה-hooks של TSAN או לשנות את המהדר.
פרטי מימוש: KCOV ועבודות רקע
חלק מתנאי הגזע כוללים עבודת רקע, למשל:
• לקבל עיבוד של מנות רשת loopback
KCOV יכול לאסוף אופציונלית כיסוי מרחוק עבור עבודות רקע בתתי-מערכות מסוימות; עם זאת, ב-Linux upstream, רוב סוגי עבודות הרקע המעניינים אותי טרם שולבו במנגנון זה, וכיסוי מרחוק משמש כיום בעיקר עבור Fuzzing של תתי-מערכות המטפלות בנתונים נכנסים מהתקנים, כמו Bluetooth ו-USB.
הפעלת יכולת זו עבור חלקים אחרים בליבה אמורה להיות פשוטה יחסית, ויש לי טיוטת תיקון לביצוע זאת עבור RCU callbacks.
מזהים יציבים עבור גישה לזיכרון בריצות: עקבות מחסנית מוגדלת
כדי לבדוק סדרים שונים של גישה לזיכרון, נדרשת דרך לזהות באופן יציב גישות זיכרון מעניינות לאורך הרצות של מקרי בדיקה. זיהוי גישות לפי כתובת הנתונים לא יעבוד אם הנתונים נמצאים באובייקט שמוקצה מחדש בכל הרצה; זיהוי לפי כתובת ההוראה (instruction address) לא יעבוד היטב אם הגישה מתבצעת בתוך פונקציות כמו memcpy() או spin_lock().
SKI פותר זאת באמצעות VM תמונת מצב, כך שכל ביצוע מתחיל מאותו מצב גלובלי.
במקום זאת, אני מזהה גישות זיכרון באמצעות עקבות מחסנית מוגדלות (count-augmented stack traces), שבהן כל רכיב בעקבת המחסנית מורכב מכתובת פונקציית callee ומספר המציין כמה קריאות לאותה פונקציה יש לדלג במסגרת המחסנית הקוראת.
דוגמה לסמנטיקה של עקבת מחסנית מוגדלת תהיה: "ב-thread הזה, בדוק את הקריאה השנייה ל-__x64_sys_recvfrom, לאחר מכן בתוכה את הקריאה הראשונה ל-__sys_recvfrom, בתוכה את הקריאה הראשונה ל-sock_recvmsg, בתוכה את הקריאה הראשונה ל-unix_stream_recvmsg, בתוכה את הקריאה הראשונה ל-unix_stream_read_generic, בתוכה את הקריאה השנייה ל-_raw_spin_unlock, ולבסוף בתוכה את הגישה הראשונה לזיכרון בכתובת ההוראה X".
זה מזהה באופן חד-משמעי נקודה בעקבת ביצוע, אינו תלוי בכתובות נתונים קונקרטיות, ויציב יחסית לשינויים בזרימת הבקרה בחלקים לא רלוונטיים של העקבה.
כדי לגרום לזה לעבוד, KCOV חייב לספק מידע על אירועי כניסה/יציאה מפונקציות, כך שבעת ניתוח פלט הכיסוי של KCOV במרחב המשתמש, ניתן יהיה לעקוב אחר השינויים בערימת הקריאות (call stack). ביצוע זה בצורה נכונה דורש תמיכה של המהדר כחלק מ-SanitizerCoverage; הטמעתי תיקון תכונה ב-LLVM עבור זה לפני מספר חודשים, אשר נכנס למהדורת LLVM 23.1.0.
כפיית צווי ביצוע עם הזרקת עיכוב
כדי לכפות סדרי ביצוע ספציפיים דרך KCOV, יישמתי ioctl בשם KCOV_SET_DI שבאמצעותו מרחב המשתמש יכול לבקש שפעולות (בעיקר wait/wake) יתבצעו בעת גישה לזיכרון בנקודות עקבת מחסנית מוגדלות ספציפיות. (ראה תיעוד בסניף הליבה שלי.) כל פעולה מגדירה דגל (flag) או ממתינה להגדרתו באינדקס המסופק על ידי המשתמש במערך דגלים משותף. סוגי הפעולות האפשריים הם:
• DI_STACK_WAKE_PRE : לפני הגישה לזיכרון, הגדר דגל N
• DI_STACK_WAIT : לפני הגישה לזיכרון, בצע spin-wait עד שדגל N יוגדר.
• DI_STACK_WAKE_POST : לאחר הגישה לזיכרון, הגדר דגל N
עם אותו ioctl, מרחב המשתמש מגדיר גם גבול עליון על איטרציות ספין-המתנה.
בנוסף, ישנם ioctls עבור מרחב המשתמש לאינטראקציה ישירה עם אותם דגלים.
API זה מאפשר שתי דרכים שונות לשימוש בהזרקת עיכוב (delay injection): הזרקת עיכוב בסגנון אילוץ (constraint-style) וסדר ביצוע מוגדר במלואו (fully-specified ordering).
הזרקת עיכוב בסגנון אילוץ (A-happens-before-B)
מרחב המשתמש יכול להגדיר סדרה של אילוצים A-happens-before-B כאשר כל אילוץ כזה מיושם כזוג פעולות בשרשורים שונים הפועלים על אותו דגל:
• DI_STACK_WAKE_POST עבור הגישה שאמורה להתרחש קודם
• DI_STACK_WAIT עבור הגישה שאמורה להתרחש שנית
בגישה זו, סדר הביצוע נותר חלקית לא-דטרמיניסטי. זה מה שהכלים הגרפיים (GUI וטרמינל UI) מיישמים כיום.
יתרון הוא שזה אינטואיטיבי יותר למקרים פשוטים; עם זאת, זה דורש רישום מידע תזמון כדי להראות למשתמש בערך את סדר האירועים, ועלול להפוך את עקבת הביצוע למסובכת יותר. לעיתים קרובות נדרשים יותר אילוצים מאשר בסדר ביצוע מוגדר במלואו, וקשה יותר להסיק מסקנות לוגיות לגבי המצב.
סדר ביצוע מוגדר במלואו (סגנון מתג-הקשר)
מרחב המשתמש יכול להחליט על סדר מסוים שבו אירועים צריכים להתרחש על ידי בחירת נקודות שבהן הביצוע יעבור מהקשר (context) אחד למשנהו. עבור המקרה הפשוט של שני הקשרי ביצוע, הדבר דורש ש-thread A יתחיל להריץ syscall בעוד ש-thread B יתחיל ב-spin-waiting על דגל; לאחר מכן, כאשר thread A מגיע לעקבת מחסנית מוגדלת מסוימת, הוא משתמש בשילוב של DI_STACK_WAKE_PRE ו-DI_STACK_WAIT כדי להשהות את הביצוע שלו ולתת ל-thread B להמשיך; לאחר מכן, thread B יכול לעשות את אותו הדבר כדי לעבור חזרה.
זו הגישה שבה השתמשתי עבור בודק השזירה האוטומטי A-B-A.