
אפקטיביות של פאזינג גרמאטי מוטציוני
אמ;לק
פאזינג גרמאטי מוטציוני הוא טכניקה המשתמשת בדקדוק מוגדר מראש ליצירת דגימות קלט. המוטציות שומרות על מבנה הדקדוק, ובכך מבטיחות שהדגימות שנוצרות עומדות בכללי התחביר. שיטה זו יעילה במיוחד באיתור באגים ותקלות בתוכנה על ידי יצירת קלטים חוקיים אך בלתי צפויים, ובשילוב עם כיסוי קוד היא מאפשרת איתור פרצות ביעילות רבה.
סיכום בעברית: מערכת VibeSec · מדיניות המקורות
נוסף ל-VibeSec:
כותרת מקורית: On the Effectiveness of Mutational Grammar Fuzzing
התוכן המלא בעברית
תרגום אוטומטי מהמקור; מונחים טכניים נשארו באנגלית. לנוסח המחייב — הכתבה המקורית.
Mutational grammar fuzzing היא טכניקת fuzzing שבה ה-fuzzer משתמש בדקדוק מוגדר מראש המתאר את מבנה הדגימות. כאשר דגימה עוברת מוטציה, המוטציות מתבצעות בצורה כזו שכל דגימה שנוצרת עדיין מצייתת לכללי הדקדוק, ולכן המבנה נשמר במהלך תהליך המוטציה. במקרה של grammar fuzzing מונחה-כיסוי, אם הדגימה שהתקבלה (לאחר המוטציה) מפעילה כיסוי קוד שלא נראה בעבר, היא נשמרת בקורפוס ומשמשת כבסיס למוטציות עתידיות.
טכניקה זו הוכחה כמסוגלת למצוא בעיות מורכבות והשתמשתי בה בהצלחה בעבר, בין היתר למציאת בעיות במימושי XSLT בדפדפני אינטרנט ואפילו בבאגים במנועי JIT.
עם זאת, למרות יעילותה של הגישה, היא אינה חפה מפגמים שעלולים לא להיות ברורים למשתמש המזדמן ב-fuzzer. בפוסט זה אציג את מה שאני תופס כפגמים בגישת ה-mutational coverage-guided grammar fuzzing. כמו כן, אתאר טכניקה פשוטה אך יעילה שבה אני משתמש בהרצות ה-fuzzing שלי כדי להתמודד עם פגמים אלו.
שימו לב שבעוד שפוסט זה מתמקד ב-grammar fuzzing, הסוגיות הנדונות כאן אינן מוגבלות אליו שכן הן משפיעות גם על טכניקות fuzzing אחרות המודעות למבנה בדרגות שונות. מחקר זה מבוסס על מימוש ה-grammar fuzzing ב-fuzzer שלי, Jackalope, אך הבעיות אינן ספציפיות ליישום זה.
בעיה מס' 1: יותר כיסוי לא אומר יותר באגים
העובדה שכיסוי קוד אינו מדד אידיאלי למציאת באגים היא עובדה ידועה המשפיעה על fuzzing מונחה-כיסוי באופן כללי, ולא רק על grammar fuzzing. עם זאת, היא נוטה להיות בעייתית יותר עבור סוגי היעדים שבהם נהוג להשתמש ב-fuzzing מודע למבנה (כולל grammar fuzzing), כגון ב-language fuzzing. בואו נדגים זאת בדוגמה:
ב-language fuzzing, באגים דורשים לרוב קריאה לפונקציות בסדר מסוים או שתוצאה של פונקציה אחת תשמש כקלט לפונקציה אחרת. כדי להפעיל באג אחרון ב-libxslt, יש לקרוא לשתי פונקציות XPath: הפונקציה document() והפונקציה generate-id(), כאשר התוצאה של document() משמשת כקלט ל-generate-id(). ישנן דרישות נוספות להפעלת הבאג, אך לעת עתה נתמקד בדרישה זו.
להלן דוגמה מינימלית הנדרשת כדי להפעיל את הבאג:
<?xml version="1.0"?> <xsl:stylesheet xml:base= "#" version= "1.0" xmlns:xsl= "http://www.w3.org/1999/XSL/Transform" > <xsl:template match= "/" > <xsl:value-of select= "generate-id(document('')/xsl:stylesheet/xsl:template/xsl:message)" /> <xsl:message terminate= "no" ></xsl:message> </xsl:template> </xsl:stylesheet>
כאשר החלק הרלוונטי ביותר לדיון זה הוא האלמנט הבא והביטוי XPath בתכונה select:
<xsl:value-of select= "generate-id(document('')/xsl:stylesheet/xsl:template/xsl:message)" />
אם תפעיל fuzzer מוטציוני מונחה-כיסוי המסוגל ליצור גיליונות סגנונות (stylesheets) של XSLT, ייתכן שהוא ייצור שתי דגימות נפרדות המכילות את הקטעים הבאים:
<xsl:value-of select= "document('')/xsl:stylesheet/xsl:template/xsl:message" />
<xsl:value-of select= "generate-id(/a)" />
האיחוד של הכיסוי משתי הדגימות הללו יהיה זהה לכיסוי של הדגימה הבעייתית, אולם החזקת document() ו-generate-id() בשתי דגימות שונות בקורפוס אינה ממש מועילה להפעלת הבאג.
ייתכן גם שה-fuzzer ייצור דגימה בודדת עם שתי הפונקציות הללו, ששוב תניב כיסוי זהה לדגימה הבעייתית, אך עם שתי פונקציות הפועלות על נתונים עצמאיים:
<xsl:template match= "/" > ... <xsl:value-of select= "document('')/xsl:stylesheet/xsl:template/xsl:message" /> <xsl:value-of select= "generate-id(/a)" /> ... </xsl:template>
סוגיה זו מדגימה כמה קריטי שכל fuzzer יהיה מסוגל לשלב מספר דגימות מהקורפוס כדי לייצר דגימות חדשות. עם זאת, שימו לב שבמקרה זה, שילוב של שתי הדגימות לא יגרום לכיסוי שלא נראה בעבר, ולכן הדגימה שהתקבלה לא תישמר, למרות שהיא קרובה יותר להפעלת הבאג.
במקרה זה, מכיוון שהפעלת הבאג מצריכה שרשור של שתי קריאות פונקציה בלבד, ה-fuzzer ימצא בסופו של דבר את הבאג על ידי שילוב אקראי של הדגימות. אך כאשר נדרש שרשור של שלוש קריאות פונקציה או יותר כדי להפעיל את הבאג, העלות לכך הופכת גבוהה משמעותית, ומשוב הכיסוי, כפי שהוכח, לא באמת עוזר.
למעשה, הפעלת באג כזה עשויה להיות קלה יותר (או קלה באותה מידה) באמצעות generative fuzzer (היוצר דגימה חדשה מאפס בכל פעם) ללא משוב כיסוי. אך למרות שמשוב כיסוי אינו אידיאלי, הוא עדיין מסייע במקרים רבים.
כפי שצוין קודם לכן, סוגיה זו משפיעה לא רק על grammar fuzzing, אלא גם על גישות fuzzing אחרות, בפרט אלו המתמקדות ב-language fuzzing. לדוגמה, התיעוד של Fuzzilli מתאר גרסה דומה של בעיה זו.
פתרון אפשרי לבעיה זו עשוי להיות סוג של כיסוי זרימת נתונים (dataflow coverage), שיכול לזהות שנתונים הזורמים מ-document() ל-generate-id() הם נתונים שלא נראו בעבר ושכדאי לשמור. עם זאת, איני מודע ליישום מעשי של גישה כזו.
בעיה מס' 2: Mutational grammar fuzzing נוטה לייצר דגימות דומות מאוד
כדי להדגים סוגיה זו, נסתכל על כמה דגימות מאחת מהרצות ה-XSLT fuzzing שלי:
<?xml version="1.0" encoding="UTF-8"?> <xsl:fallback namespace= "http://www.w3.org/url2" ><aaa ></aaa><ddd xml:id= "{lxl:node-set($name2)}:" att3= "{[$name4document('')att4.|document('')$name4namespace::]document('')}{ns2}" ></ns3:aaa></xsl:fallback>
<?xml version="1.0" encoding="UTF-8"?> <xsl:fallback namespace= "http://www.w3.org/url2" ><aaa ></aaa><ddd xml:id= "{lxl:node-set($name2)}:" att3= "{[$name4document('')att4.|document('')$name4namespace::]document('')}{ns2}" xmlns:xsl= "http://www.w3.org/url3" ><xsl:output ></xsl:output> eHhDC?^5= <xsl:choose elements= "eee" ><xsl:copy stylesheet-prefix= "ns3" priority= "3" ></xsl:copy></xsl:choose></ddd> t </xsl:fallback>
כפי שניתן לראות מהדוגמה, למרות ששתי הדגימות הללו שונות ומגיעות מנקודות זמן שונות במהלך הרצת ה-fuzzing, חלק גדול מהן זהה.
הדבר נובע מהטבע החמדני של mutational coverage-guided fuzzing: כאשר דגימה עוברת מוטציה כדי לייצר כיסוי חדש, היא נשמרת מיד בקורפוס. סביר להניח שחלק גדול מהדגימה המקורית לא עבר מוטציה, אך מכיוון שהוא עדיין מהווה חלק מהדגימה החדשה, הוא נשמר. הדגימה החדשה הזו יכולה לעבור מוטציה שוב, ואם הדגימה (השלישית) שהתקבלה מפעילה כיסוי חדש, גם היא תישמר, למרות דמיון רב לדגימה ההתחלתית. הדבר מוביל לחוסר גיוון כללי בקורפוס המיוצר על ידי mutational fuzzing.
בעוד שמוטטור הדקדוק של Jackalope יכול גם להתעלם מדגימת הבסיס וליצור דגימה שלמה מאפס, נדיר שזה יפעיל כיסוי חדש בהשוואה למוטציות מקומיות יותר, במיוחד בשלבים מאוחרים יותר של ה-fuzzing.
גישה אחת למאבק בבעיה זו יכולה להיות מזעור (minimization) של כל דגימה חדשה כך שרק החלק שמפעיל כיסוי חדש יישמר, אך הבחנתי שגם זו אינה אסטרטגיה אופטימלית, ומועיל להשאיר חלק מהדגימה המקורית. Jackalope מיישם זאת על ידי מזעור כל דגימת דקדוק, אך עוצר את המזעור כאשר מגיעים למספר מסוים של אסימוני דקדוק.
למרות שפוסט זה מתמקד ב-grammar fuzzing, הבחנתי בסוגיה זו גם עם fuzzers אחרים המודעים למבנה.
פתרון פשוט?
שתי הסוגיות הללו רומזות לכך שעשויים להיות יתרונות לשילוב בין generative fuzzing לבין mutational fuzzing בדרך כלשהי. ה-generative fuzzing מייצר דגימות מגוונות יותר מאשר mutational fuzzing, אך סובל מבעיות אחרות, כמו העובדה שהוא מייצר בדרך כלל המון דגימות המפעילות שגיאות ביעד. בנוסף, כפי שצוין קודם לכן, למרות שכיסוי אינו קריטריון אידיאלי למציאת באגים, הוא עדיין מסייע במקרים רבים.
בעבר, כשעסקתי ב-grammar fuzzing על מספר רב של מכונות, השתמשתי בגישה של עיכוב סנכרון ה-fuzz workers. כך, כל worker עבד בתחילה עם קורפוס משלו (עצמאי לחלוטין). רק לאחר זמן מה, ה-fuzzers החליפו סטים של דגימות, וכל worker קיבל את הדגימות המתאימות לכיסוי שחסר לו.
אך מה עושים כשמבצעים fuzzing במכונה אחת? במהלך פרויקט ה-XSLT fuzzing שלי, השתמשתי בגישה הבאה:
• הפעל worker עם קורפוס ריק למשך T שניות.
• לאחר T שניות, סנכרן את ה-worker עם שרת ה-fuzzing. קבל מהשרת את הכיסוי החסר ואת הדגימות המתאימות. העלה לשרת כל כיסוי שאינו קיים בו (יחד עם הדגימות המתאימות).
• המשך להריץ עם קורפוס משולב (שנוצר על ידי ה-worker + שהתקבל מהשרת) למשך T שניות נוספות.
• סנכרן שוב עם השרת (כדי להעלות דגימות חדשות) וכבה את ה-worker.
התוצאה היא שה-worker מבלה חצי מהזמן ביצירת קורפוס עצמאי לחלוטין מאפס, וחצי מהזמן בעבודה על קורפוס גדול יותר המשלב גם דגימות מעניינות (לפי מדד הכיסוי) מה-workers הקודמים. הדבר מוביל ליותר גיוון בדגימות, מכיוון שכל דור חדש אינו תלוי בקודמו. עם זאת, בסופו של דבר ה-worker עדיין מסיים עם סט דגימות התואם לכיסוי המלא שנראה לאורך כל תקופת הפעילות שלו. באופן אידיאלי, ניתן למצוא כיסוי חדש, וחשוב מכך, באגים חדשים, על ידי שילוב דגימות טריות מהדור הנוכחי עם דגימות מדורות קודמים.
ב-Jackalope, ניתן ליישם זאת על ידי הפעלת השרת תחילה, למשל:
/path/to/fuzzer -start_server 127.0.0.1:8337 -out serverout
ולאחר מכן הרצת ה-workers ברצף באמצעות סקריפט Python הבא:
import subprocess import time T = 3600 while True : subprocess . run ([ " rm " , " -rf " , " workerout " ]) p = subprocess . Popen ([ " /path/to/fuzzer " , " -grammar " , " grammar.txt " , " -instrumentation " , " sancov " , " -in " , " empty " , " -out " , " workerout " , " -t " , " 1000 " , " -delivery " , " shmem " , " -iterations " , " 10000 " , " -mute_child " , " -nthreads " , " 6 " , " -server " , " 127.0.0.1:8337 " , " -server_update_interval " , str ( T ), " -- " , " ./harness " , " -m " , " @@ " ]) time . sleep ( T * 2 ) p . kill ()
שימו לב שהפרמטרים של Jackalope בסקריפט לעיל לקוחים מהרצת ה-libxslt fuzzing שלי ויש להתאים אותם בהתאם ליעד.
בנוסף, Jackalope מיישמת את הדגל -skip_initial_server_sync כדי להימנע מסנכרון ה-worker עם השרת מיד עם תחילת הפעולה, אך דגל זה הוא כעת ברירת המחדל במצב grammar fuzzing ולכן אין צורך לציין אותו במפורש.
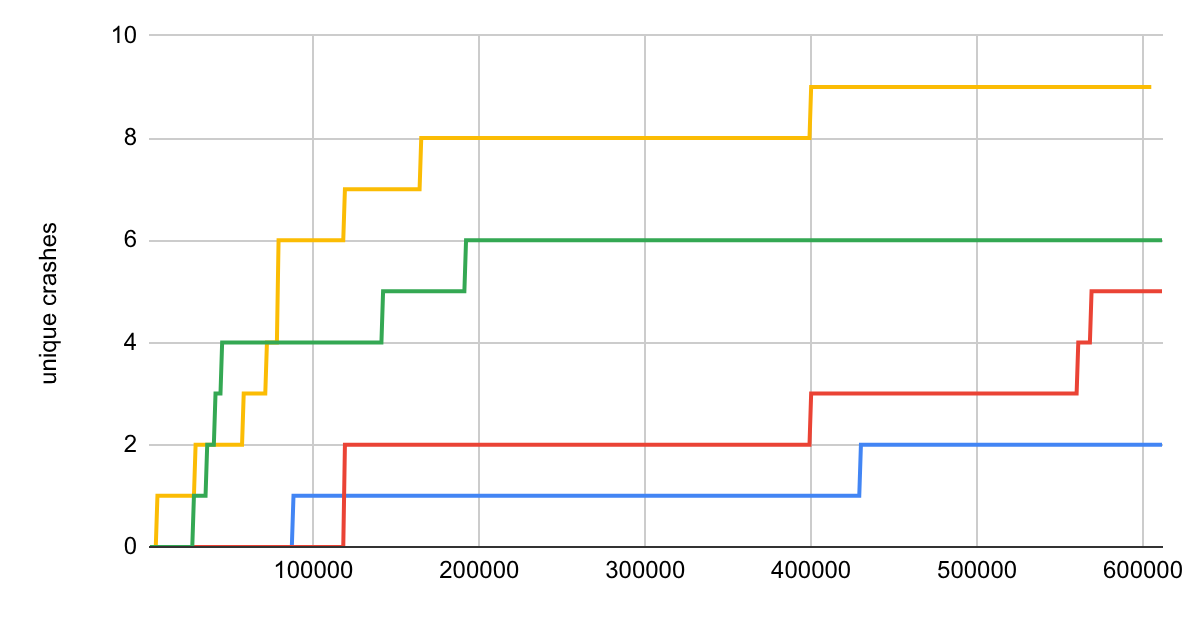
האם הטריק הזה עובד טוב יותר מאשר הרצת session יחיד של fuzzing ללא הפרעות? בואו נבצע כמה ניסויים. השתמשתי בגרסה ישנה יותר של libxslt בתור היעד (libxslt commit 2ee18b3517ca7144949858e40caf0bbf9ab274e5, libxml2 commit 5737466a31830c017867e3831a329c8f605c877b) ומדדתי את מספר הקריסות הייחודיות לאורך זמן. שימו לב שבעוד שמספר הקריסות הייחודיות אינו תואם ישירות למספר הבאגים הייחודיים, היכולת להפעיל את אותו באג בדרכים שונות עדיין נותנת אינדיקציה טובה ליכולות איתור הבאגים. הרצתי כל session במשך שבוע אחד על מכונה בודדת.
הרצתי שני ניסויי ברירת מחדל (עם worker יחיד שפועל לאורך זמן) וכן שני ניסויים עם הפתרון המוצע, עם ערכים שונים של T: שעה אחת (T=3600) ו-10 דקות (T=600).